빅분기 필기는 기출만 여러 번 돌리면 붙는 시험으로 알려져 있었는데요. 올해 상반기 12회에서는 합격률이 30%에도 못 미쳤어요. 기출 문항을 그대로 외워서는 넘기 어려워졌다는 뜻입니다. 이 글에서는 최근 회차에 자주 나온 주제를 과목별로 모아 보고, 어느 순서로 잡으면 좋을지 정리했어요.
12회 이후 빅분기 필기 출제경향, 뭐가 달라졌나 📈
지난 회차 필기 합격률은 차이가 컸습니다. 60%를 넘긴 회차도 있었지만, 2026년 4월 12회는 응시자 열 명 중 셋도 붙지 못했어요.
12회를 치른 수험생 후기를 보면 처음 보는 개념과 용어가 예상보다 많았다는 이야기가 공통적으로 나옵니다. 수험생들이 복원한 12회 출제 키워드에도 RNN과 트랜스포머, 은닉 마르코프 모델, 하둡 수집 도구 척와(Chukwa)처럼 예전 기출에서 자주 보이지 않던 이름이 섞여 있어요.

그렇다고 기출이 쓸모없어진 건 아닙니다. 같은 키워드 목록을 보면 왜도, 중심극한정리, 가설검정 오류, 릿지 회귀, 앙상블, F1-Score, ROC 커브처럼 여러 회차에 걸쳐 돌아오는 주제도 여전히 많아요. 자주 나오는 주제는 정확히 잡고, 처음 보는 용어는 선지 속 핵심 단어로 걸러 내는 방식이 필요해진 셈입니다.
필기는 과목당 20문항씩 80문항이고, 평균 60점을 넘기면서 과목마다 40점 이상이어야 합격이에요. 문항 수로 바꾸면 전체 48문항을 맞히면서 과목마다 8문항은 꼭 챙겨야 합니다.
과목별로 자주 돌아오는 빅분기 빈출 주제 📌

1과목 빅데이터 분석 기획
암기 비중이 큰 과목입니다. 가명처리와 비식별화 기법, 개인정보보호법과 신용정보법 조항이 자주 나와요. 하둡 생태계 도구도 단골인데, Sqoop과 Chukwa, HDFS가 각각 어떤 일을 하는지 한 줄로 구분할 수 있어야 합니다.
2과목 빅데이터 탐색
결측값과 이상값 처리, 로그 변환과 Box-Cox 같은 변수 변환이 먼저 나옵니다. 기초통계량에서는 왜도 부호에 따라 평균, 중앙값, 최빈값의 크기 순서가 바뀌는 문제가 자주 보여요. 1종 오류와 2종 오류, 중심극한정리, 표본분산을 n-1로 나누는 이유도 반복되는 주제입니다.
3과목 빅데이터 모델링
비전공자가 가장 많이 막히는 과목이에요. 릿지와 라쏘가 과적합과 다중공선성을 어떻게 줄이는지, 배깅과 부스팅이 어떻게 다른지는 꾸준히 묻는 주제입니다. 의사결정나무의 분리 기준과 군집분석의 연결법, 인공신경망의 순전파와 역전파도 용어를 바꿔 가며 다시 나와요.
4과목 빅데이터 결과 해석
혼동행렬에서 나오는 정밀도, 재현율, F1-Score와 ROC 커브가 중심입니다. 시각화 파트는 스타 차트, 평행 좌표 그래프, 체르노프 페이스를 구분하는 문제가 나오고, 분석모형 전개에서 리모델링까지 이어지는 결과 활용 단계는 순서를 묻는 문항으로 나와요.
계산기 없이 풀어야 하는 계산 문항
빅분기 필기는 계산기를 쓸 수 없습니다. 그래서 계산 문항은 공식을 알아도 손으로 빨리 푸는 연습이 안 돼 있으면 시간을 크게 잡아먹어요.

자주 나오는 계산은 대부분 숫자가 깔끔하게 떨어지도록 출제됩니다. 연관규칙의 지지도, 신뢰도, 향상도는 전체 거래 수와 동시 구매 건수만 알면 나눗셈 두세 번으로 끝나요. 향상도가 1보다 크면 양의 연관, 1이면 서로 독립이라는 해석까지 같이 묻습니다.
의사결정나무의 지니 지수는 1에서 각 클래스 비율의 제곱합을 빼면 되고, 두 클래스가 반반이면 0.5가 최댓값이라는 점을 외워 두면 선지를 빨리 지울 수 있어요. 유클리드, 맨해튼 거리 계산과 기댓값·분산의 성질도 같은 방식으로 반복 연습해 두세요.
헷갈리는 개념은 짝으로 묶어서 외우기
최근 회차 오답을 보면 모르는 개념보다 비슷한 두 개념을 바꿔 쓴 선지에서 틀리는 경우가 많습니다. 그래서 개념을 하나씩 외우기보다 짝으로 묶어 차이를 한 줄로 정리하는 방법이 효과적이에요.
| 헷갈리는 짝 | 구분 기준 |
| 표준화 vs 정규화 | 평균·표준편차 기준 변환 vs 범위를 0~1로 조정 |
| 1종 오류 vs 2종 오류 | 참인 귀무가설 기각 vs 거짓 귀무가설 채택 |
| PCA vs 변수 선택 | 새 축을 만듦 vs 기존 변수 중 일부를 고름 |
| 배깅 vs 부스팅 | 병렬로 학습 vs 오답에 가중치를 두고 순차 학습 |
| 피어슨 vs 스피어만 | 실제 값의 선형 관계 vs 순위 기반 관계 |
오답노트도 정답만 적기보다, 틀린 선지가 왜 틀렸는지 한 문장으로 남기는 편이 좋아요. 오답을 전처리, 통계, 회귀, 분류, 군집처럼 단원별로 나눠 두면 어느 과목에서 과락 위험이 있는지 바로 보입니다.
💡 1과목과 4과목에서 점수를 넉넉히 확보해 두면, 3과목이 어렵게 나온 회차에서도 과락만 피하면 평균을 맞출 수 있어요.
빈출 주제에 ★를 단 46페이지 요약본
바라톡 빅데이터분석기사 필기 핵심요약 PDF는 9월 18일 개정판에서 46페이지로 새로 정리됐어요. 4과목을 출제기준 순서대로 배치했고, 기출 비중이 높은 주제에는 ★ 표시를 달아 어디부터 볼지 바로 알 수 있게 했습니다. 이번 글에서 다룬 평가지표, 회귀분석, 앙상블, 확률분포도 모두 들어 있어요.

모델링 파트의 한 페이지입니다. 연관규칙의 지지도, 신뢰도, 향상도를 식과 함께 표로 정리하고, 우유와 빵 거래 예시로 향상도 1.25가 나오는 과정을 풀어 놓았어요. ★★가 붙은 군집분석은 유클리드부터 코사인 유사도까지 거리 척도를 한 표에 모았고, 연결법 비교표에는 틀린 설명 고르기로 출제된다는 메모를 달았습니다.
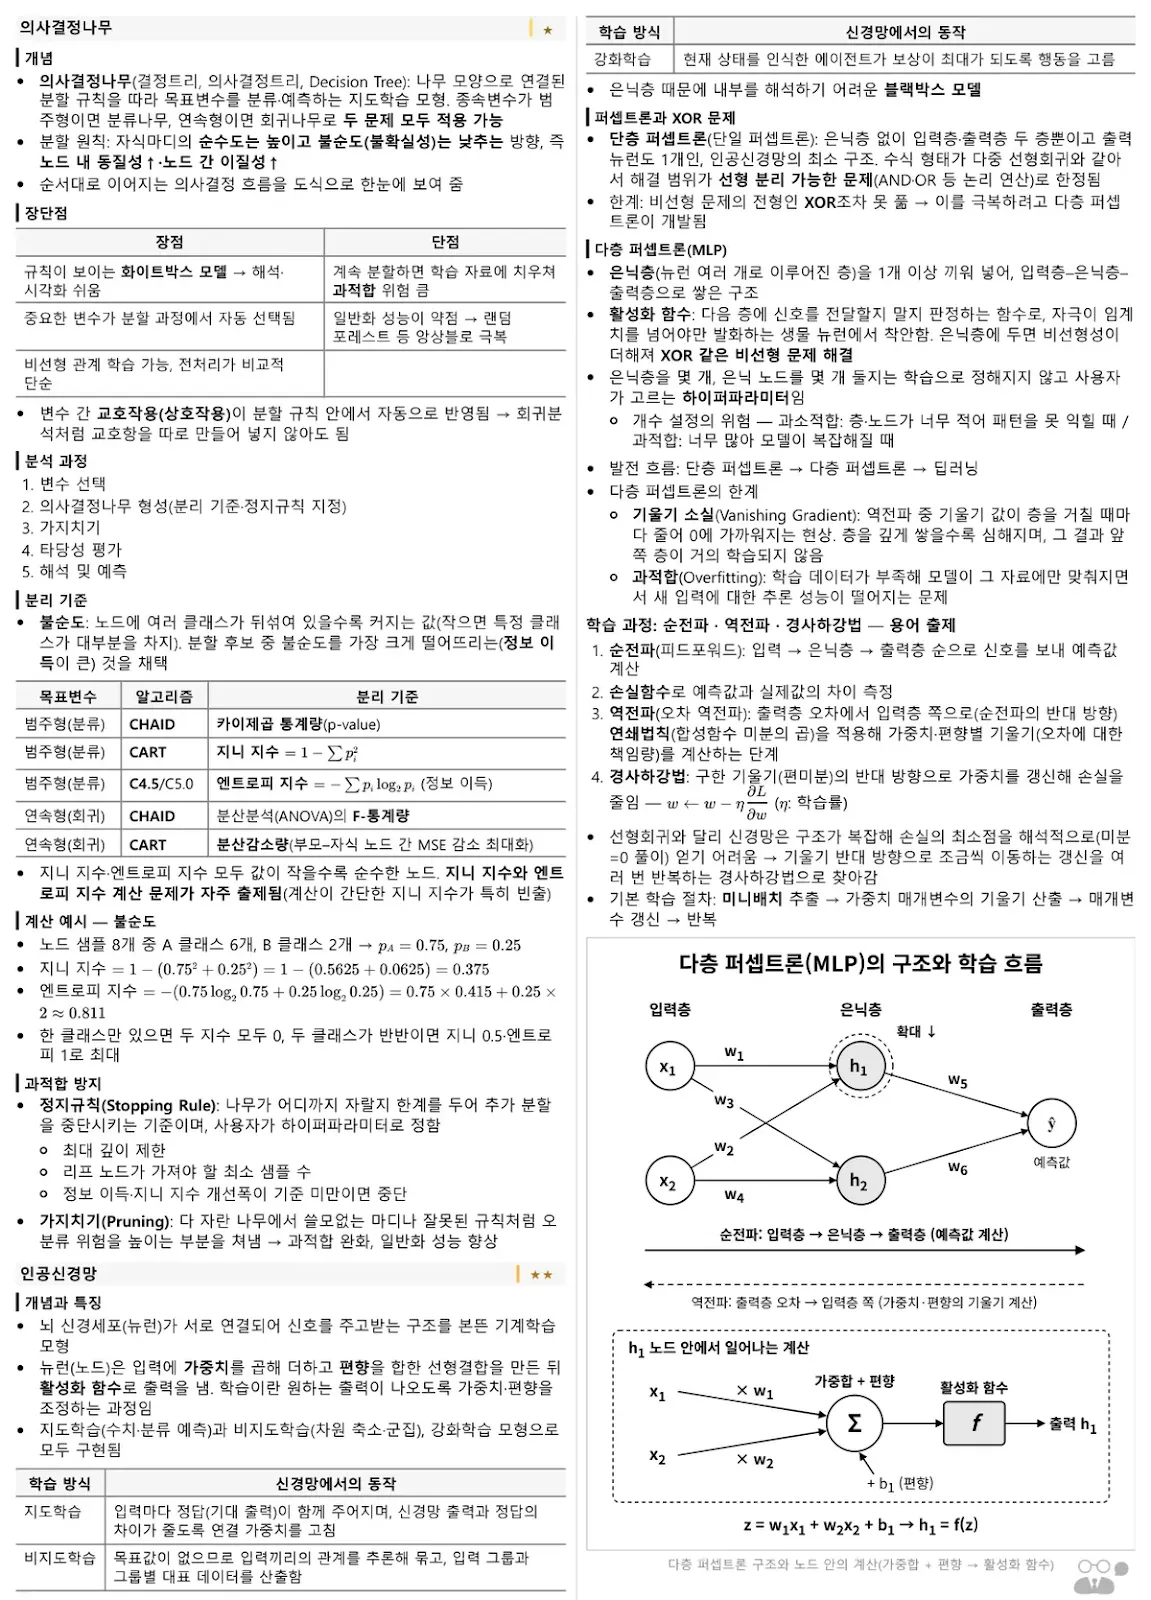
의사결정나무는 CHAID, CART, C4.5의 분리 기준을 목표변수 유형별로 나눴고, 지니 지수와 엔트로피를 같은 노드로 직접 계산해 비교했어요. 인공신경망은 순전파, 역전파, 경사하강법을 순서대로 정리하고 다층 퍼셉트론 구조를 그림으로 넣었습니다.

탐색 파트는 피어슨, 스피어만, 켄달 상관계수 비교표와 변수 유형별 분석 기법 표로 시작해요. 기초통계량에서는 왜도 부호에 따른 평균, 중앙값, 최빈값 위치를 그래프로 보여 주고, 공분산이 0이어도 독립이 아닐 수 있다는 자주 나오는 함정도 짚었습니다.

결과 해석 파트는 스타 차트, 평행 좌표 그래프, 체르노프 페이스를 같은 데이터로 그려 비교했어요. 인포그래픽 유형과 분석결과 활용 단계의 순서도 표로 정리돼 있습니다.
👉 빈출 주제에 ★ 표시한 빅분기 필기 요약 PDF
https://www.baratalk.com/library/빅데이터분석기사-필기-핵심요약-pdf
빅데이터분석기사 필기 핵심요약 자료 pdf
빅데이터분석기사 필기 핵심만 담은 46페이지 요점 요약본. 평가 지표·회귀분석·앙상블·확률분포 등 4과목을 출제기준 순서로 정리하고 기출 비중이 높은 주제에 ★을 달았습니다. 즉시 PDF 다
www.baratalk.com
13회 발표 이후, 다음 일정 챙기기
13회 필기 합격자 발표는 9월 23일에 났어요. 합격하셨다면 실기 접수가 10월 26일부터 30일, 실기 시험이 11월 28일, 최종 발표가 12월 18일입니다. 응시자격 서류 제출 기간은 데이터자격검정(www.dataq.or.kr) 공지로 꼭 확인해 주세요.
이번에 아쉽게 떨어졌다면 다음 필기 일정은 2027년 시행 공고로 확인하시면 됩니다. 빅분기 필기 출제경향은 기출 반복만으로는 부족해졌지만, 자주 나오는 주제는 여전히 분명해요. ★ 주제와 계산 문항부터 확실히 잡고, 헷갈리는 개념 짝을 정리하는 순서로 준비해 보세요.
🎯 빅데이터분석기사 필기 출제경향 반영, 핵심요약 PDF
https://www.baratalk.com/library/빅데이터분석기사-필기-핵심요약-pdf
빅데이터분석기사 필기 핵심요약 자료 pdf
빅데이터분석기사 필기 핵심만 담은 46페이지 요점 요약본. 평가 지표·회귀분석·앙상블·확률분포 등 4과목을 출제기준 순서로 정리하고 기출 비중이 높은 주제에 ★을 달았습니다. 즉시 PDF 다
www.baratalk.com
필기에서 가장 까다로웠던 과목은 어디였나요? 댓글로 남겨 주시면 함께 응원할게요 😊