SQLD 기출문제는 제2과목의 그룹 함수, 함수, DDL, 서브쿼리, 윈도우 함수부터 푸는 게 순서입니다. 출제경향 리포트에서 그룹 함수가 8.3%로 가장 높고 나머지 넷도 6.8~7.9%라, 세부항목 30개 가운데 비중이 가장 큰 다섯 개예요. SQLD 제63회는 접수가 10월 16일에 이미 끝났고 시험은 11월 14일(토)이라, 오늘(10월 23일) 기준으로 3주 남짓 남았습니다(정확한 일정은 한국데이터산업진흥원 공지에서 확인해 주세요). 남은 기간에 SQLD 기출문제를 어디부터 어떻게 풀지, 실제 수록 문항부터 보면서 정리해 볼게요.

SQLD 기출문제는 실제로 어떤 모양인가요? 🧩
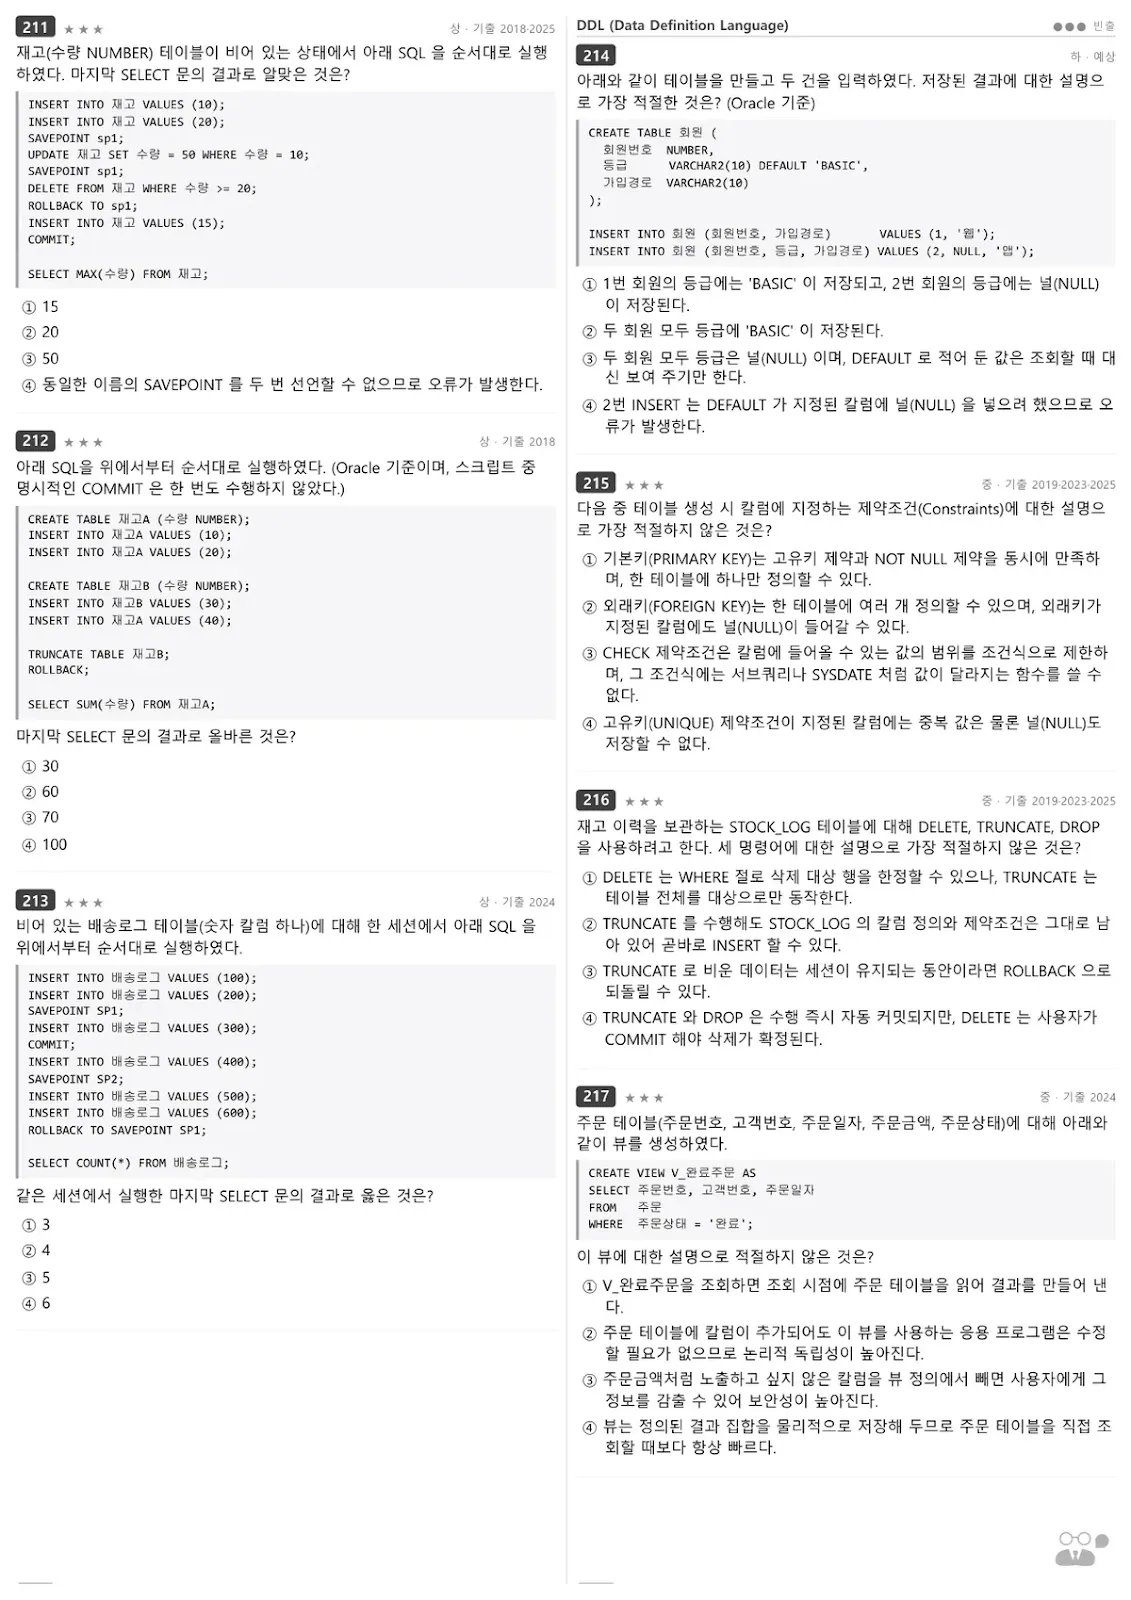
코드를 한 줄씩 따라가야 답이 나오는 문항과, 정의를 살짝 맞바꾼 보기를 골라내는 문항이 많습니다. 문제편 미리보기에 실린 난이도 상, 별 셋 문항 하나를 그대로 옮겨 볼게요.
재고(수량 NUMBER) 테이블이 비어 있는 상태에서 아래 SQL을 순서대로 실행하였다. 마지막 SELECT 문의 결과로 알맞은 것은?
| 순서 | 실행한 SQL |
|---|---|
| 1 | INSERT INTO 재고 VALUES (10); |
| 2 | INSERT INTO 재고 VALUES (20); |
| 3 | SAVEPOINT sp1; |
| 4 | UPDATE 재고 SET 수량 = 50 WHERE 수량 = 10; |
| 5 | SAVEPOINT sp1; |
| 6 | DELETE FROM 재고 WHERE 수량 >= 20; |
| 7 | ROLLBACK TO sp1; |
| 8 | INSERT INTO 재고 VALUES (15); |
| 9 | COMMIT; |
| 10 | SELECT MAX(수량) FROM 재고; |
보기는 ① 15 ② 20 ③ 50 ④ "동일한 이름의 SAVEPOINT를 두 번 선언할 수 없으므로 오류가 발생한다"입니다. 같은 이름의 SAVEPOINT가 두 번 나온다는 점이 ④ 보기로 이어져 있어서, 문법을 대충 알고 있으면 여기서 흔들려요. 정답과 한 줄씩 따라간 풀이는 해설편에 있으니 먼저 직접 따라가 보세요.
제1과목은 모양이 다릅니다. 해설편 미리보기의 한 문항은 수강신청번호 하나만으로 모든 인스턴스가 구분되는데 신청일자를 덧붙여 주식별자를 만든 사례를 주고, 어떤 특성이 깨졌는지 묻습니다. 해설은 속성을 하나 더 붙여도 유일성은 그대로 지켜지지만, 필요한 최소한의 속성으로 주식별자를 구성해야 한다는 최소성을 놓쳤다고 설명해요. 유일성이 깨지지 않으니 오히려 최소성 위반을 놓치기 쉽다는 경고까지 붙어 있습니다.
SQLD 기출문제는 어느 세부항목에서 가장 많이 나오나요? 📊
제2과목 SQL 활용의 그룹 함수가 8.3%로 가장 높습니다. 그다음이 SQL 기본의 함수 7.9%, 관리 구문의 DDL 7.2%, SQL 활용의 서브쿼리와 윈도우 함수가 각각 6.8%예요. 아래는 상품에 함께 든 출제경향 리포트의 세부항목 30개 가운데 비중이 큰 12개를 옮긴 것입니다.
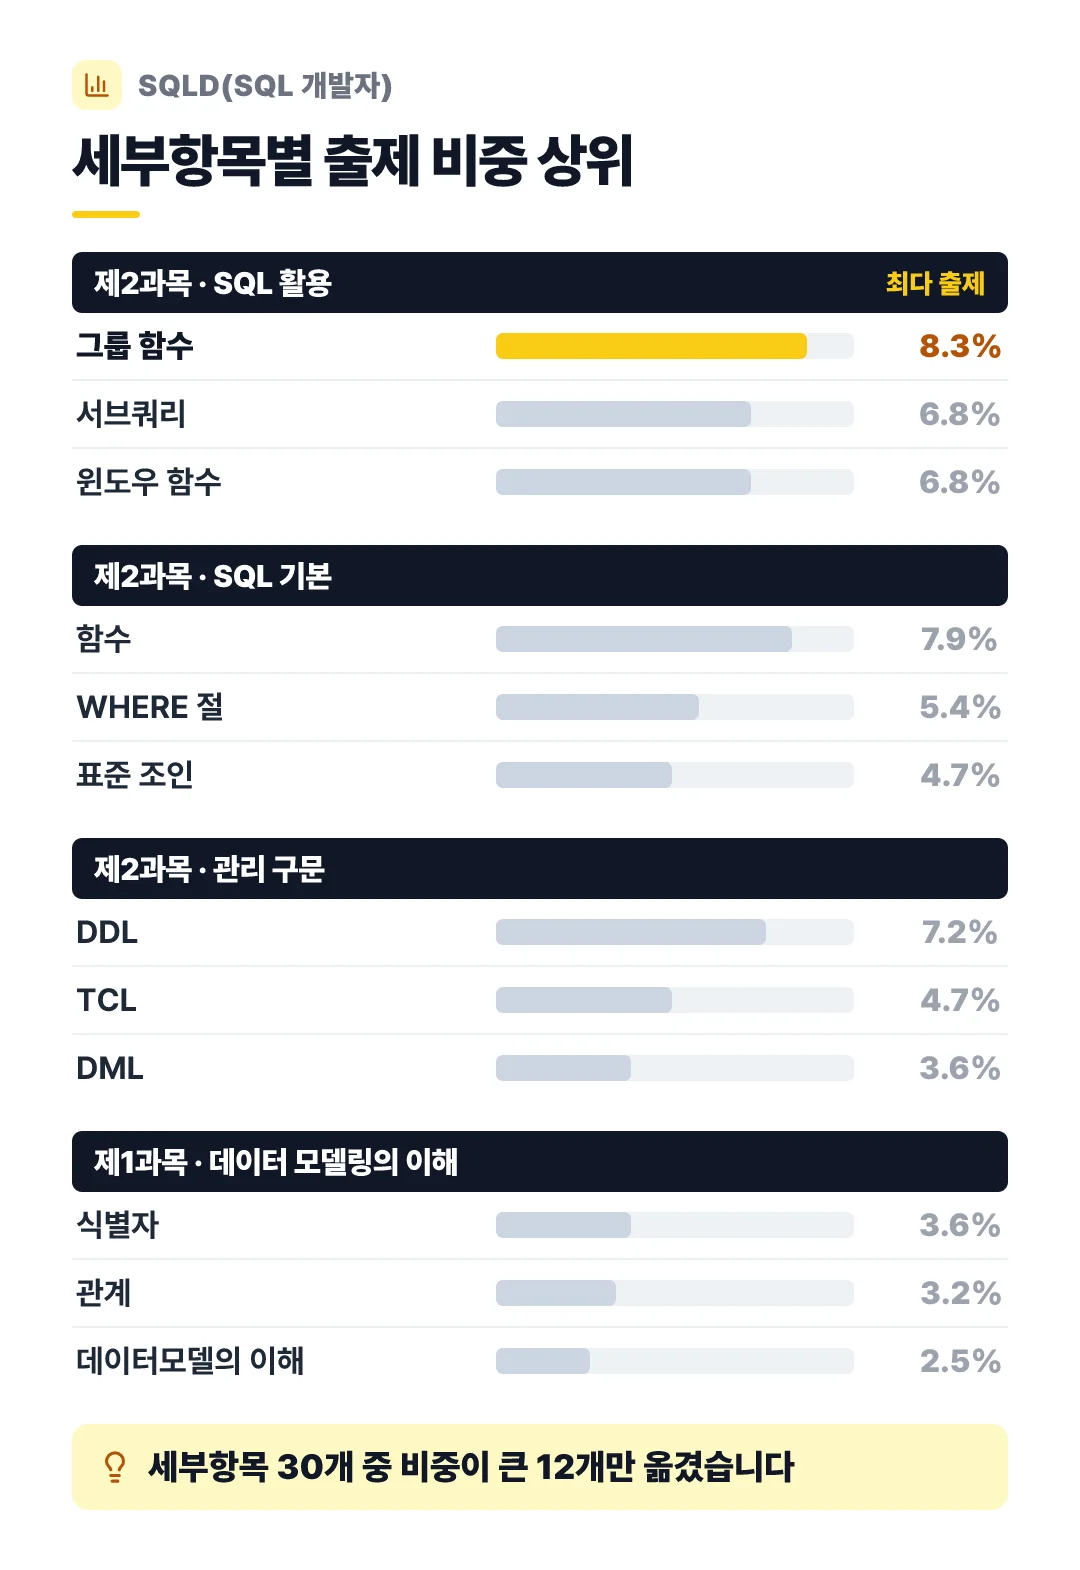
제1과목 데이터 모델링의 이해에서는 가장 높은 식별자도 3.6%에 그칩니다. 반대로 비중이 0.7%로 가장 낮은 세부항목은 '모델이 표현하는 트랜잭션의 이해', '본질식별자 vs 인조식별자', 'PIVOT 절과 UNPIVOT절' 세 개예요.
다만 리포트는 비중이 낮거나 표시가 없는 항목도 출제기준에는 포함되니 개념 정리 수준의 대비는 필요하다고 적고 있습니다. 이 비중은 분석에 쓴 최근 기출 회차 기준이라 연도와 회차에 따라 달라질 수 있고, 앞으로의 출제를 보장하는 값도 아니에요. 순서를 정하는 기준으로 쓰는 게 맞습니다.
SQLD 기출문제, 아는 문법인데 왜 틀리나요? 🔍
문법을 아는 것과 여러 문장을 실행한 결과를 따라가는 것이 서로 다른 능력이기 때문입니다. 미리보기에 실린 문항만 봐도 함정이 어디에 놓이는지 보여요.
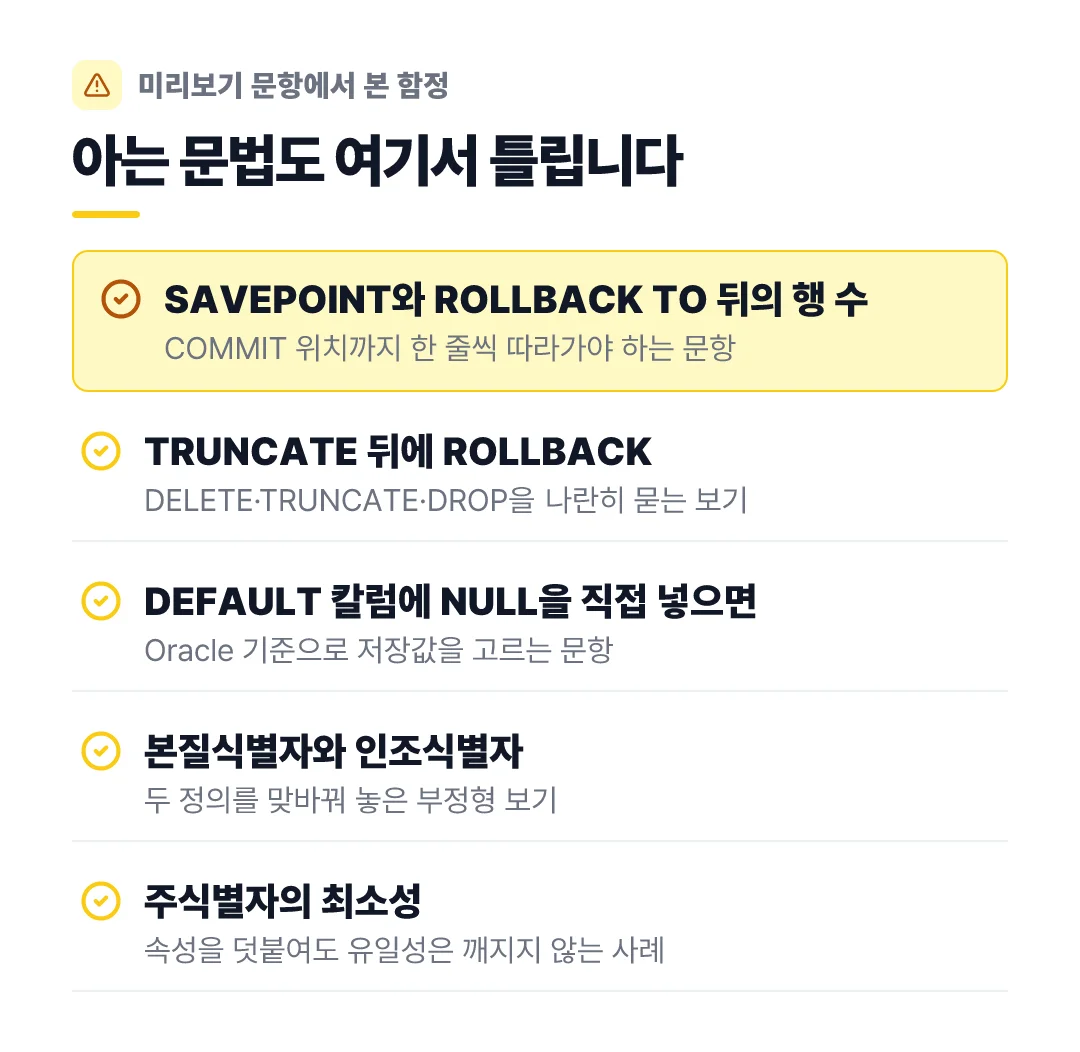
관리 구문 쪽은 실행 순서가 답을 바꿉니다. TRUNCATE TABLE 뒤에 ROLLBACK을 둔 문항, SAVEPOINT를 만든 다음 COMMIT을 하고 나서 그 SAVEPOINT로 돌아가려는 문항, DEFAULT 'BASIC'이 지정된 칼럼에 NULL을 직접 넣었을 때 저장되는 값을 고르는 문항(Oracle 기준)이 나란히 실려 있어요. DELETE·TRUNCATE·DROP 세 명령어를 한 문항에서 비교하게 하고, 뷰에 대해서는 결과 집합을 물리적으로 저장해 두므로 원본 테이블을 직접 조회할 때보다 항상 빠르다는 보기를 섞어 둡니다.
제1과목은 용어의 정의를 맞바꾸는 방식이에요. 해설편 미리보기에는 본질식별자와 인조식별자의 정의를 서로 바꿔 놓은 보기, 식별자 관계와 비식별자 관계를 언제 쓰는지 기준을 뒤집은 보기를 고르는 부정형 문항이 이어집니다. 두 용어를 따로 외워 두기만 하면 보기 문장에서 주어만 바뀐 걸 놓치기 쉬워요.
남은 3주, SQLD 기출문제는 어떤 순서로 풀어야 하나요? 🗓️
비중이 큰 제2과목 세부항목부터 풀고, 제1과목은 정의를 맞바꾼 보기를 가려내는 연습으로 마무리하는 순서를 권합니다.
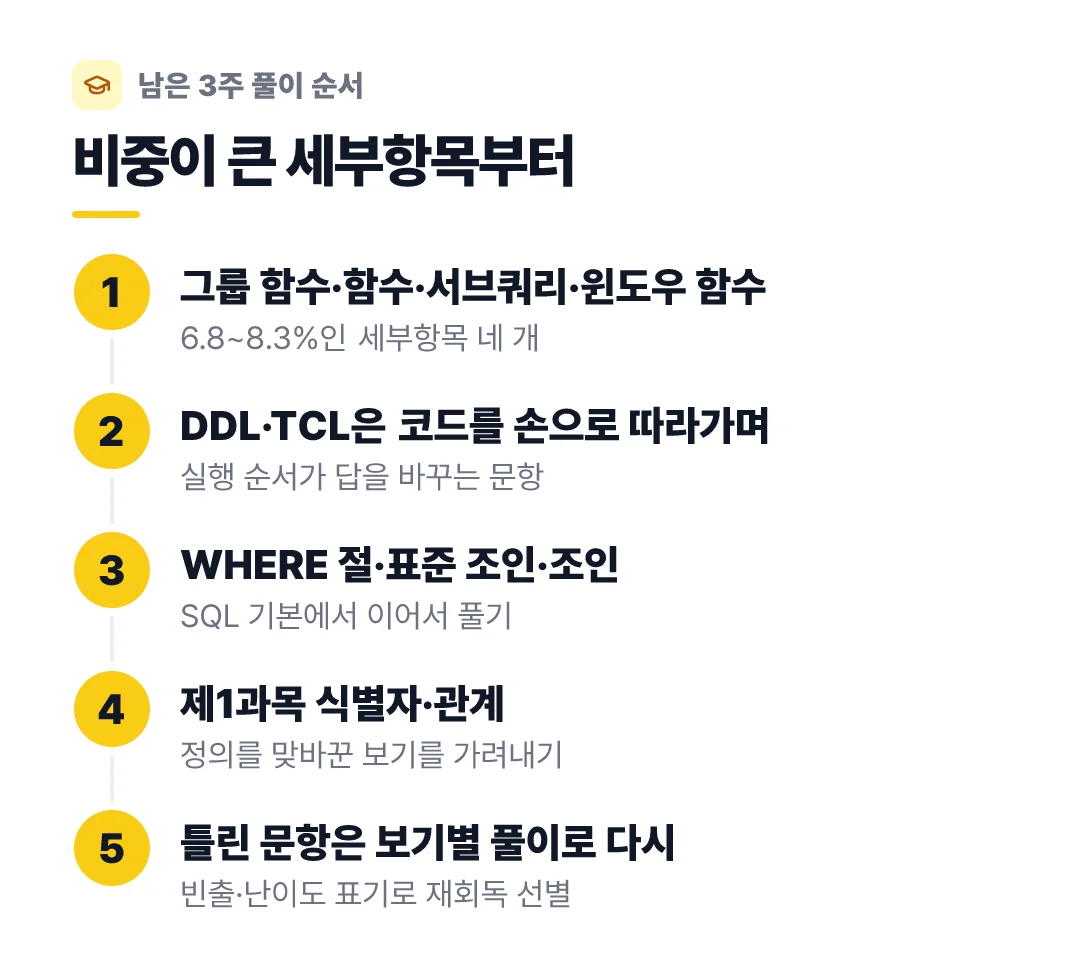
- 그룹 함수·함수·서브쿼리·윈도우 함수를 먼저 풉니다. 네 세부항목의 비중이 6.8~8.3%라 여기서 시간을 쓰는 만큼 돌아옵니다.
- DDL·TCL은 코드를 눈으로 읽지 말고 종이에 행을 적어 가며 한 줄씩 따라가세요. 위 SAVEPOINT 문항처럼 실행 순서가 답을 정합니다.
- WHERE 절, 표준 조인, 조인으로 SQL 기본을 이어서 채웁니다.
- 제1과목 식별자·관계는 짧게 여러 번 봅니다. 비중은 낮아도 부정형 보기가 많아 실수가 잦은 곳이에요.
- 틀린 문항은 정답 번호만 확인하지 말고 해설의 보기별 근거까지 읽고, 문항마다 붙은 빈출·난이도 표기로 다시 풀 문항을 골라냅니다.
문제은행이 출제기준 차례대로 묶여 있어서, 세부항목 이름만 보고 해당 단원을 바로 펼칠 수 있다는 점이 이 순서를 따라가기 쉽게 해 줍니다.
SQLD 문제은행 PDF에는 무엇이 들어 있나요? 📘
데이터 모델링의 이해와 SQL 기본 및 활용 두 과목의 문항을 출제기준 차례대로 모은 98쪽 PDF입니다. 현행 세부항목 30개를 빠짐없이 채웠고, 모든 문항에 풀이형 해설과 빈출·난이도 표기를 달았으며, 출제경향 분석 리포트를 함께 담았어요.

아래 세 장은 상품 미리보기입니다. 첫 장이 위 비중 카드의 원본인 리포트의 '출제기준 전 세부항목 × 출제 비중' 페이지, 두 번째가 문제편, 세 번째가 해설편이에요.


👉 SQLD 기출문제집 바로가기
https://www.baratalk.com/exams/sqld-qbank
SQLD 기출문제, 자주 묻는 질문 ❓
Q. 출제 비중은 어떤 기준으로 낸 값인가요?
리포트는 분석에 쓴 최근 기출 회차를 기준으로 비중을 냈고, 연도와 회차에 따라 달라질 수 있다고 적고 있어요. 앞으로의 출제를 보장하는 값이 아니라 푸는 순서를 정하는 기준으로 쓰는 게 맞습니다.
Q. 비중이 낮은 제1과목은 건너뛰어도 되나요?
리포트는 비중이 낮거나 표시가 없는 항목도 출제기준에 포함되니 개념 정리 수준의 대비는 필요하다고 안내합니다. 식별자·관계처럼 부정형 보기가 많은 곳은 짧게 여러 번 보는 쪽을 권해요.
Q. 해설은 어떤 방식인가요?
모든 문항에 풀이형 해설과 빈출·난이도 표기가 붙어 있습니다. 해설편 미리보기의 최소성 문항처럼, 왜 그 보기가 틀렸는지 근거까지 설명해요.
Q. 몇 쪽이고, 어디서 볼 수 있나요?
데이터 모델링의 이해와 SQL 기본 및 활용 두 과목을 출제기준 차례대로 모은 98쪽 PDF입니다. 미리보기 세 장과 구성은 https://www.baratalk.com/exams/sqld-qbank 에서 볼 수 있어요.
접수는 이미 끝났으니 이제 남은 건 3주 동안 무엇을 먼저 푸느냐입니다. 오늘은 위 SAVEPOINT 문항 하나를 종이에 행을 적어 가며 따라가 보세요. 한 문항에 걸리는 시간이 보이면, 그룹 함수부터 DDL까지 하루에 몇 쪽씩 나갈지 바로 정할 수 있습니다.
📘 단원 순서대로 푸는 SQLD 기출문제 — 문제은행 PDF
https://www.baratalk.com/exams/sqld-qbank
SQLD 세부항목 가운데 유독 손이 안 가는 곳 하나만 꼽아 주세요. 댓글로 남겨 주세요 🙂